Doc2Alpaca
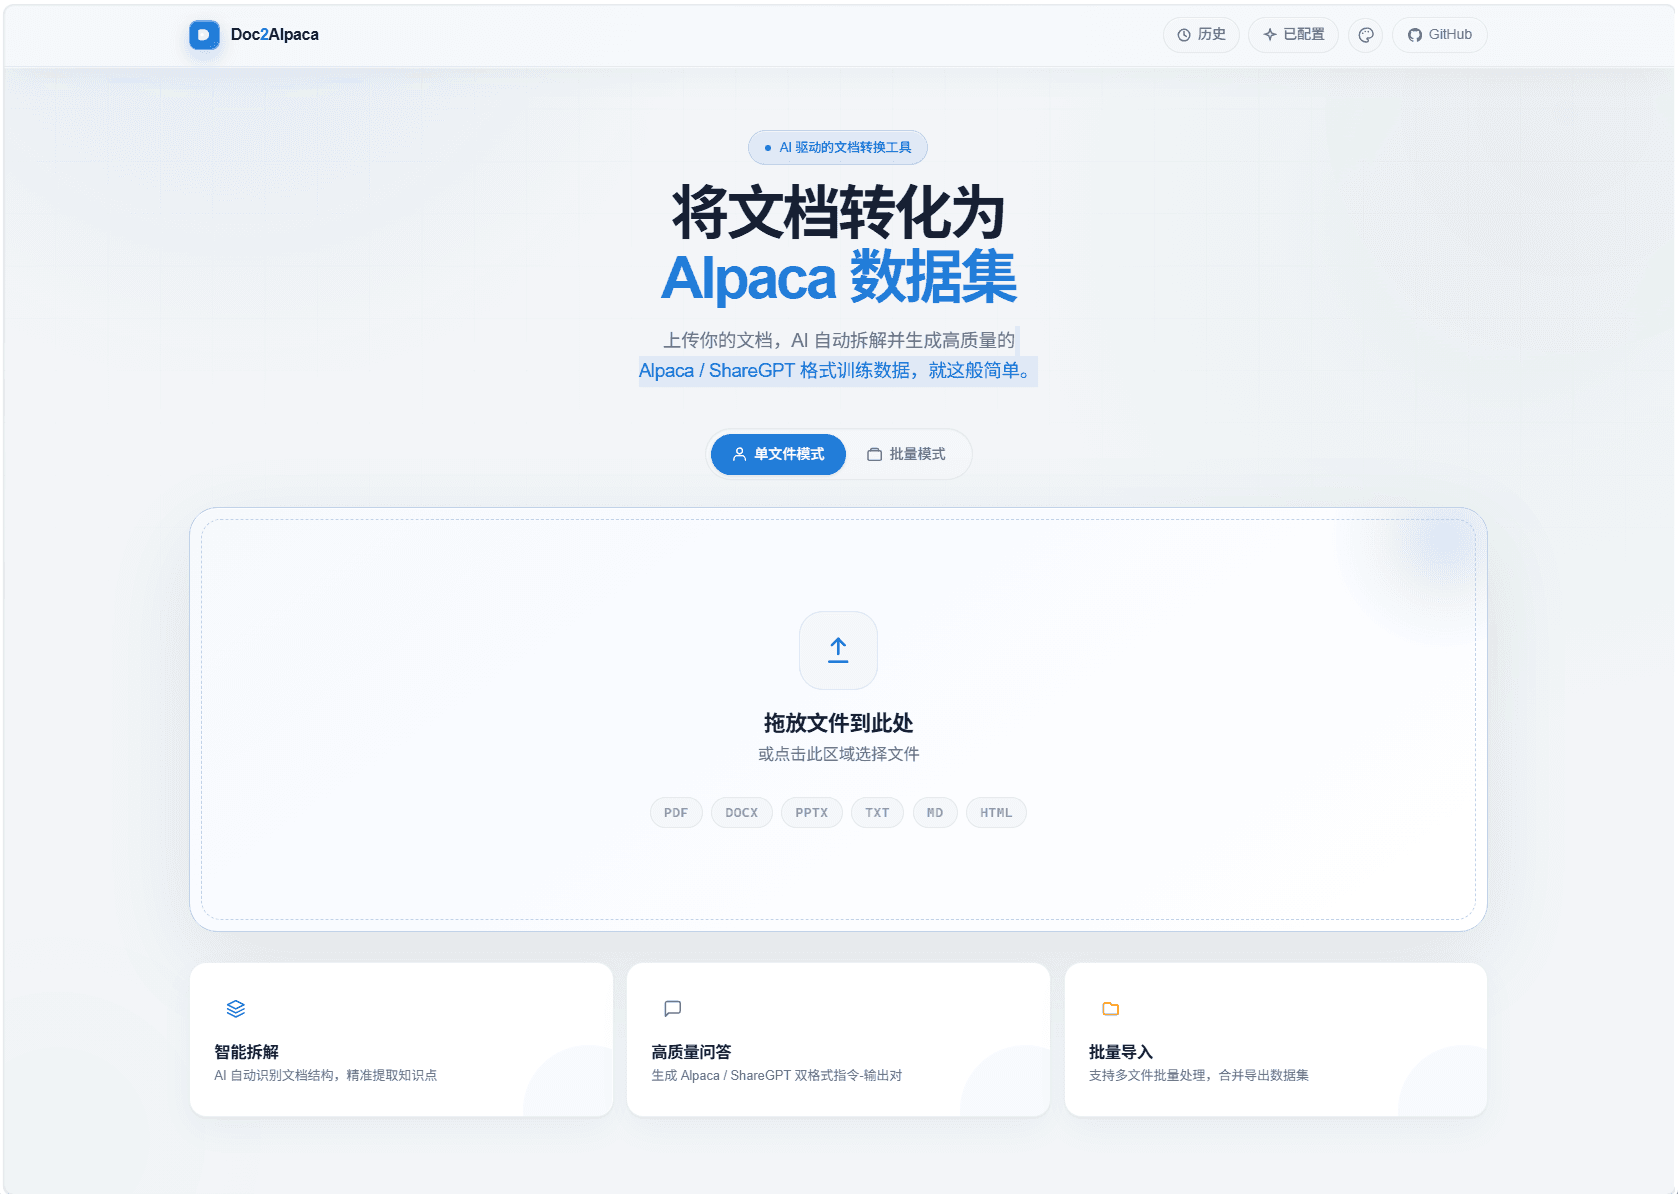
把文档里的知识,整理成能审、能改、能导出的训练数据。
一个面向微调数据整理的全栈应用:把多格式文档拆成可处理的内容块,生成候选问答,经过人工审核后导出为 Alpaca 或 ShareGPT 数据集。
- Next.js
- TypeScript
- OpenAI-compatible API
- PostgreSQL
- Redis
- RabbitMQ
- Docker Compose
- Electron

AI 应用全栈工程师在校生
以 Python 与 FastAPI 为后端主链路,专注 LLM、Agent、ReAct 与 RAG 应用,并用 Next.js 把能力交付成完整产品。
$ whoami。→ 陈嘉豪 / AI 应用全栈工程师。$ focus --current。→ LLM · Agent · ReAct · RAG · FastAPI。$ status。→ OPEN_TO_INTERNSHIP。$ build --latest。→ 开源发布版 v1 / BUILDING
一个正在持续构建的 AI 应用工程师档案。
三个案例全部来自真实源码、构建或真机证据;公开地址、测试结果与尚未完成的边界都明确写出。
把文档里的知识,整理成能审、能改、能导出的训练数据。
一个面向微调数据整理的全栈应用:把多格式文档拆成可处理的内容块,生成候选问答,经过人工审核后导出为 Alpaca 或 ShareGPT 数据集。


先把项目拆清楚,再让编码工具开工。
一个面向 AI 编程新手的项目规划 Skill:通过一问一答收拢范围、拆清模块与接口,再输出可以交给 Codex、Claude Code、Cursor 等工具分阶段执行的开发包。
15 门 Bilibili 网课和 9 个学习网站都附有真实来源、插图、推荐等级,以及下一步练习建议;先选一条主线,再用项目验证。
网课推荐
15 门课程 · 09 个资料站
已核验课程
按工程基础、服务交付、模型原理、检索增强和智能体系统分组;每一项都给出推荐等级、真实时长与下一步练习。
03 门

李勃老师 ·《AI 时代的全栈开发》系列
从前端、后端、运维的职责与关联出发,先建立全栈地图,再讨论 AI 编程时代为什么仍需要理解工程。系列按 8 个模块、23 节课组织,并提供文字课件与示例代码。
我的评价它先把完整产品链路摆在眼前,适合避免只会调用模型、却不清楚产品如何落地的学习误区。
建议先跟着这一节画出自己的技术地图,再按页面、接口、数据与部署四条线分别补强。
边界这是一条学习路线的开场,不应代替后续项目里的真实编码、排障和部署练习。

精选优课译站 · Scrimba / freeCodeCamp 课程译制
一条从 HTML、CSS、JavaScript 延伸到 React、Node.js、SQL、TypeScript 与 Next.js 的超长实践路线,视频分 6 P,并附 GitHub 挑战代码与交互式课程入口。
我的评价覆盖面很广,适合把缺失的 Web 基础补齐,而不是把每一节都当作必须从头顺序观看的任务。
建议先用目录定位自己不会的环节;每学完一个模块,就做一个可运行的小页面或接口来验证。
边界总时长接近 47.5 小时,拆分节奏比一次性刷完更重要。

高低肩真的难受 · Bilibili
公开页面将它定位为工作中的 Git 入门教程;官方接口记录时长为 29 分 40 秒,发布于 2023 年 3 月。
我的评价适合在进团队仓库或接入部署流程前快速建立操作地图,重点不只是记命令,而是理解提交、分支和远程协作。
建议建立一个可随时删除的练习仓库,亲手完成分支、合并、冲突解决和一次恢复操作。
边界短教程不能替代冲突、变基和误操作恢复的实战;这些一定要在隔离仓库里练过。
04 门

枫枫知道 · 24 P 系列课程
围绕 PostgreSQL 的基础使用、SQL 与数据库能力展开,共 24 个分节,并在视频简介中提供配套文字文档。
我的评价对准备做 AI 应用后端的人很实用:用户、任务、历史记录和检索元数据都离不开关系型数据建模。
建议用一个小项目建表、写约束、做查询,再把数据访问接到 FastAPI,不要只停在命令行练习。
边界入门课程不等于生产数据库设计;索引、迁移、事务边界与备份仍要在项目中继续练。

简单-编程 · 动画概念课
用短动画依次解释正向与反向代理、upstream、轮询与权重、故障转移、动静分离,以及 server / location / proxy_pass 等核心配置。
我的评价短时间建立“请求到底经过哪里”的直觉非常划算,能让后续部署配置不再只是复制粘贴。
建议先画出浏览器、Nginx、前端和 API 的请求路径,再用本地 Compose 环境复现一条反向代理。
边界概念动画不代替实际配置;HTTPS、缓存、安全头和线上故障排查要跟官方文档继续学习。

GeekHour · 8 P 入门系列
把 Nginx 入门拆成 8 个分节,适合在理解反向代理概念后继续熟悉安装、配置与常用操作;课程说明另提供配套笔记获取方式。
我的评价它正好补上短概念课没有展开的配置和操作,和上一门 Nginx 课程搭配会比单独观看更有效。
建议用自己的 Next.js 与 FastAPI 项目做一次静态资源与 API 反代配置,并记录可复用的最小配置。
边界配置能跑通不代表线上安全;不要直接把示例配置原样用于公网服务。

GeekHour · 19 P 入门系列
公开接口记录该教程共 19 P、时长 57 分 51 秒;简介提到 Redis 命令、安装笔记和 RedisInsight 配套资料。
我的评价Redis 是 AI 应用里缓存、会话、限流和短任务状态的常见支点,先学清基础会少很多后端盲区。
建议同时启动本地 Redis,在 FastAPI 中亲手做缓存、TTL、失效策略和服务不可用时的降级路径。
边界入门不涵盖生产环境的持久化选择、内存策略、监控、集群与安全;需要时应查 Redis 官方文档。
04 门

堂吉诃德拉曼查的英豪 · Bilibili
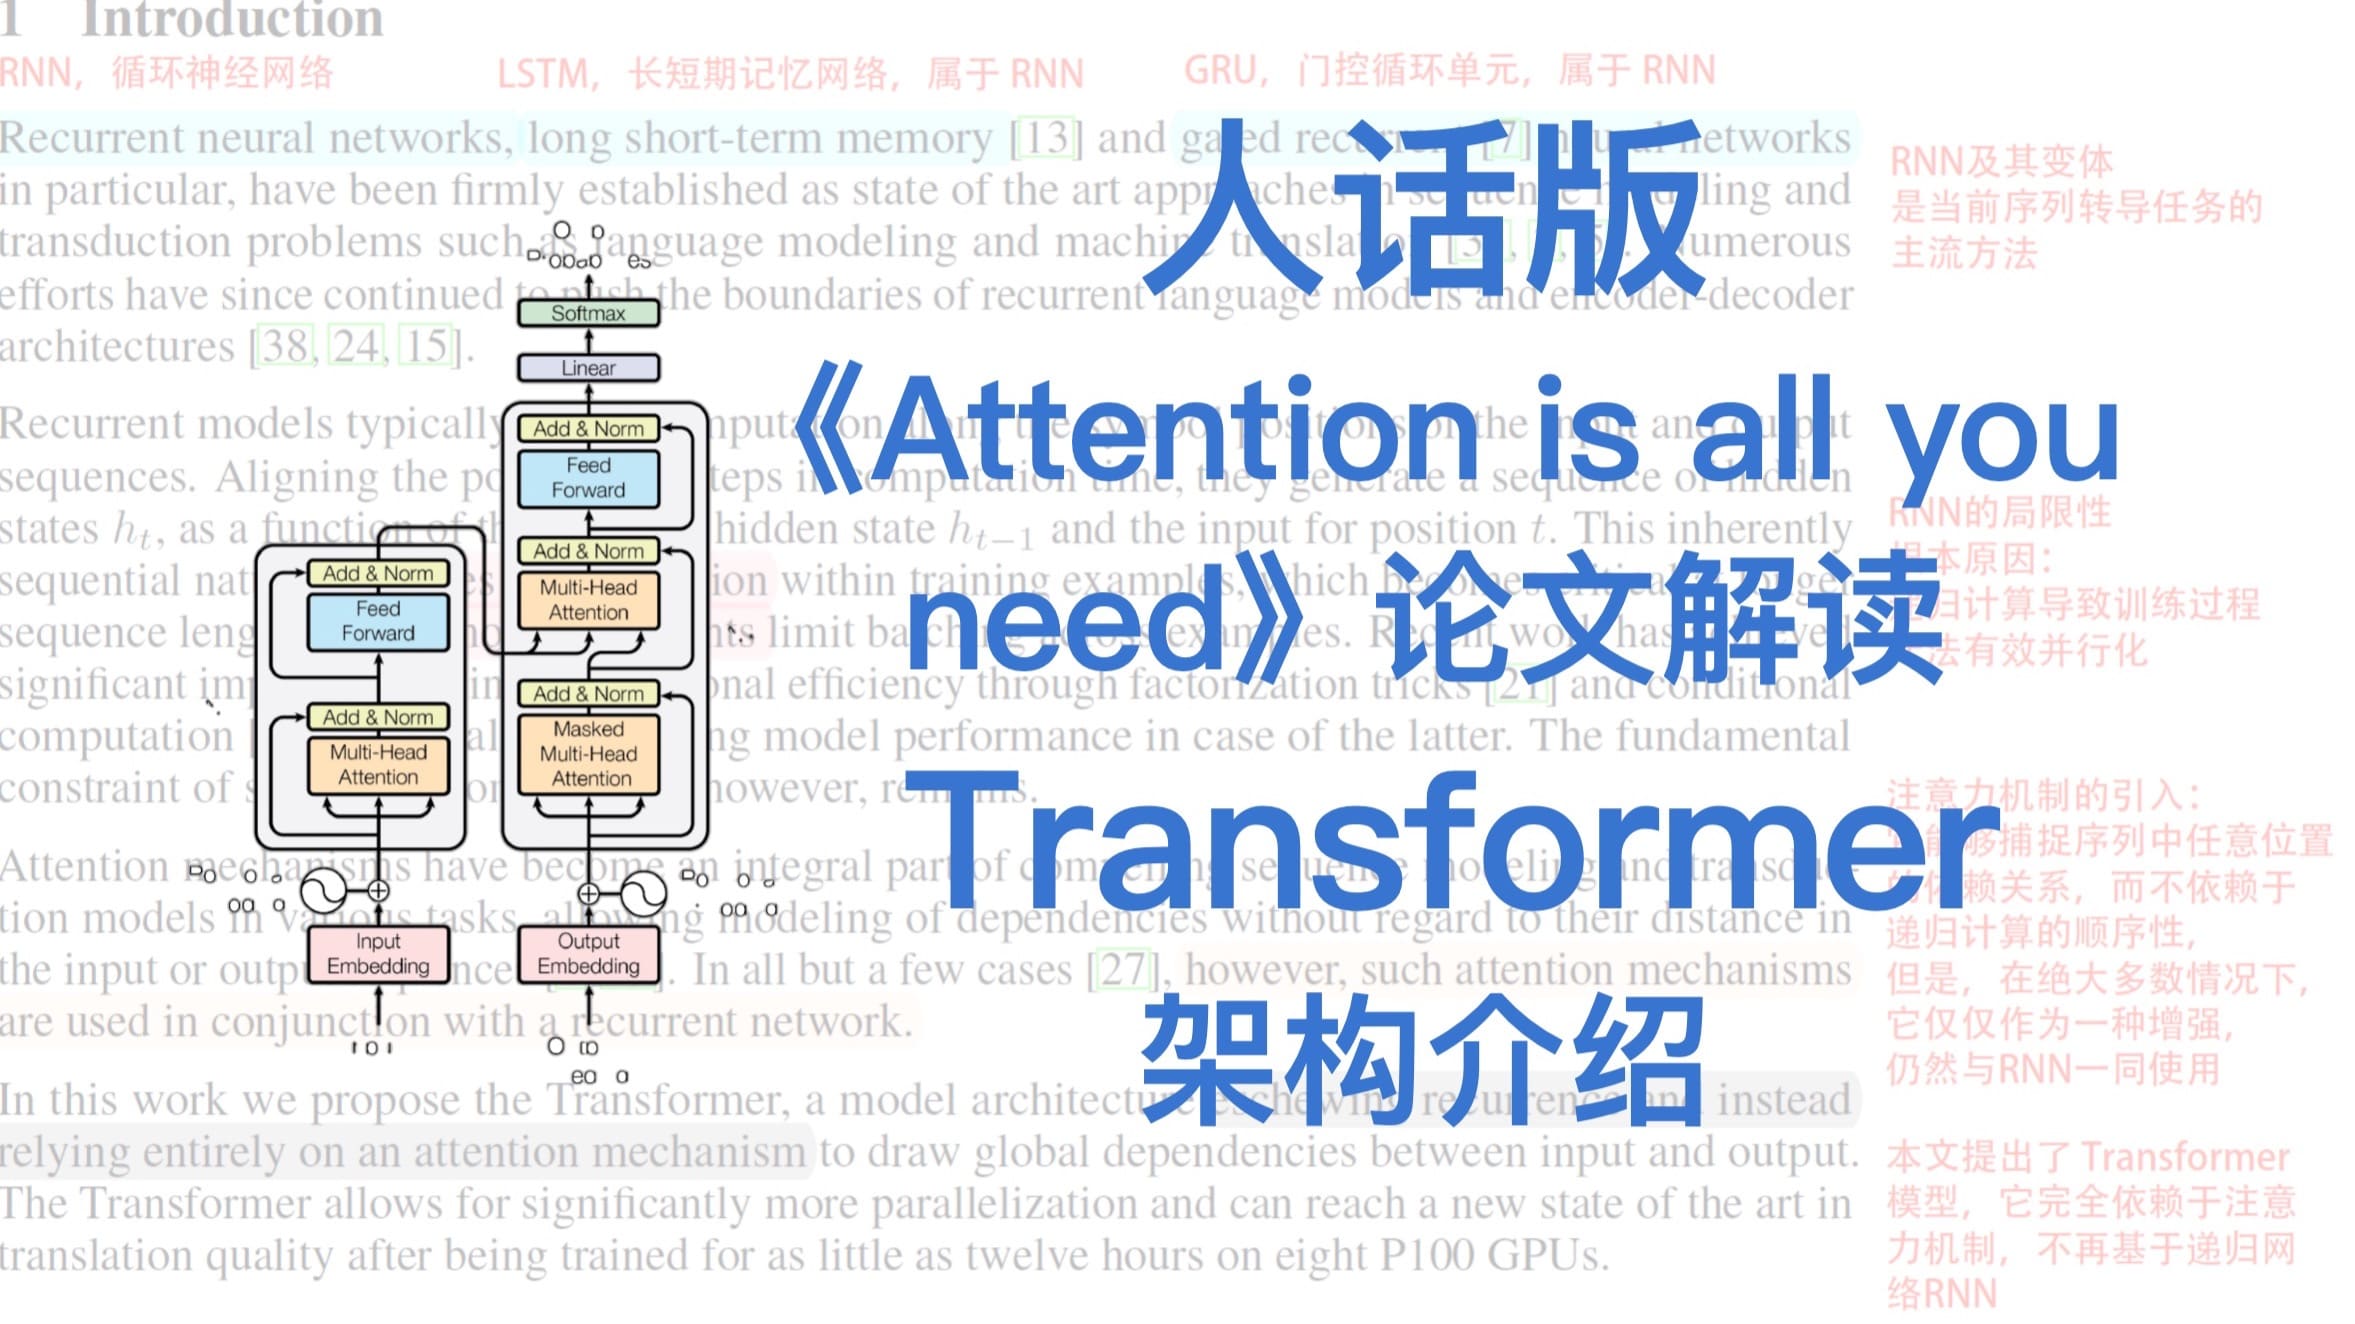
公开接口记录它是一门 52 分 32 秒的 Transformer 论文解读课程;视频简介还提供了 PPT 与论文笔记链接。
我的评价它是从“会调用模型”走向“理解模型为什么这样工作”的好桥梁,尤其适合补足注意力与编码器—解码器的结构直觉。
建议边看边手绘多头注意力的数据流;遇到矩阵、softmax 或损失函数再针对性补基础。
边界论文解读无法替代线性代数与深度学习前置知识,公式看不懂时应停下来补,而不是硬记结论。

farfar的AI4S日记 · Bilibili
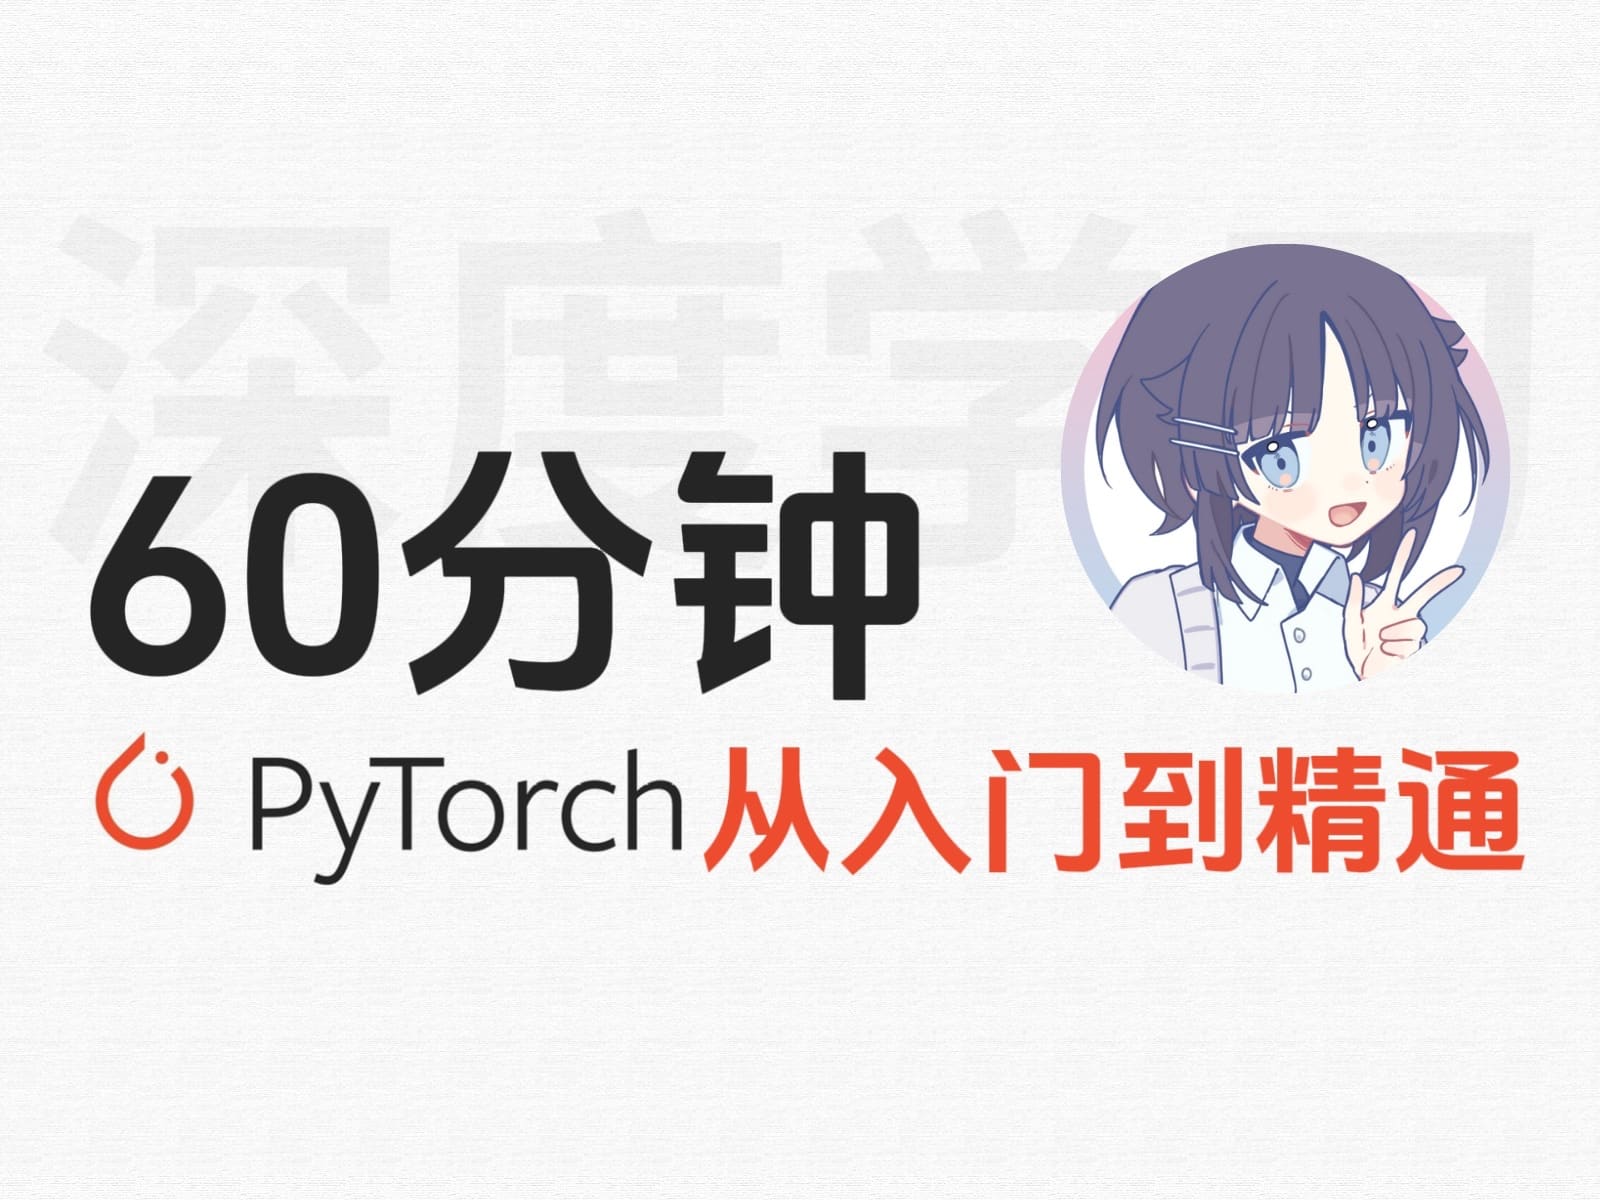
公开视频标题写“60 分钟”,但官方公开接口当前返回时长为 4 分 27 秒;简介说明创作者使用动画分享机器学习知识。
我的评价更适合作为 PyTorch 的快速热身或概念入口,而不应被误当成完整的训练框架课程。
建议观看后立刻完成张量、数据集、训练循环、验证和检查点保存五个 Notebook 小练习。
边界页面按官方接口展示 4 分 27 秒,不会把标题中的“60 分钟”误写成真实课程长度。

费曼学徒冬瓜 · Bilibili
公开简介提到 LlamaFactory,并覆盖理论、环境、数据准备、模型选择、数据蒸馏、调参与评估;官方接口时长为 1 小时 35 分 27 秒。
我的评价优点在于把微调看成数据、配置和评估共同决定的工程过程,而不是“跑一次训练命令”。
建议先复现实验规模很小的样例,记录基座模型、数据、配置和对照基线,再看指标变化。
边界应先判断提示词、检索或产品交互能否解决问题,不能因为“会微调”就过早上训练。

吴恩达机器学习_StanFord · Bilibili 整理合集
公开接口显示该合集有 23 P、共 27 小时 32 分 39 秒;简介说明上传者整理了课件、代码与参考资料。
我的评价它适合做长期的 NLP 理论主线,帮助理解模型结构为何出现、带来什么代价,而不是只学库函数。
建议按周推进:一讲、一篇阅读、一段小实验,并写下每种架构选择解决了什么问题。
边界页面核验的是 Bilibili 整理合集,课件与代码的最终来源仍应和 Stanford 官方课程页交叉确认。
02 门

code秘密花园 · Bilibili
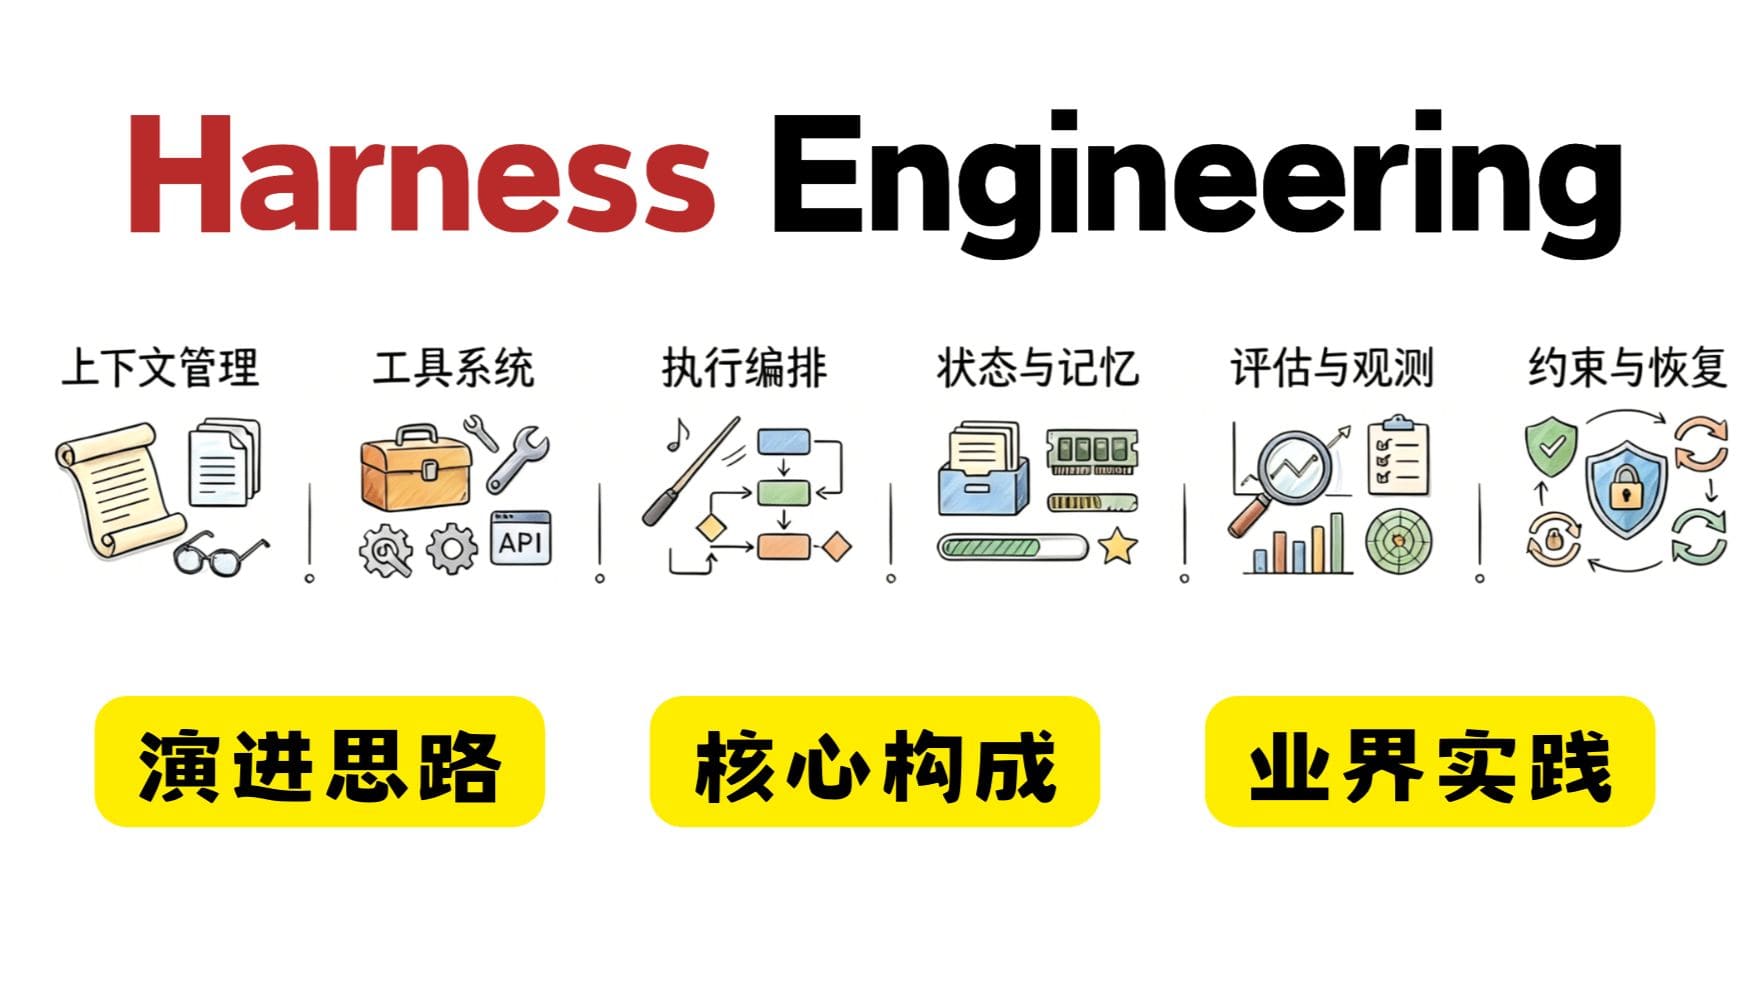
公开视频简介从 Prompt 与 Context Engineering 的演进讲到 Harness 的构成、实践以及 OpenAI / Anthropic 案例;官方接口时长为 18 分 31 秒。
我的评价适合作为近期 AI 工程概念的导航图,帮助把工具、上下文、评测、可观测性与失败处理看成同一个系统。
建议选自己的一个项目,写下工具边界、上下文来源、评测方法、日志和失败恢复五项清单。
边界这是短概览;涉及具体框架和产品的结论,开始实现前仍应回到一手文档核验。

木乔_Mokio · Bilibili
公开接口显示课程为 20 P、共 2 小时 50 分 54 秒;简介给出了代码仓库、理论分支、Notion 笔记与 PPT 资料。
我的评价它把理论和代码放在一起,对已经会写 Python、准备搭第一个 Agent 的人特别有帮助。
建议按分 P 拆成学习单元,只实现一个最小 Tool Call 循环,再逐步加状态、评测与恢复。
边界覆盖范围很广,不适合把它当作零编程基础的唯一入口。
02 门

AI敲代码的阿Q · Bilibili
公开接口记录时长为 25 分 35 秒;视频将自身定位为为学习者梳理大模型与 RAG 方案的资源。
我的评价适合已经搭过基础 RAG 后拓展实验假设,例如切分、召回、重排和查询路由该从哪里开始比较。
建议先固定一小组问题、参考答案和成本预算,再一次只替换一个环节,记录变化。
边界不存在脱离语料、质量目标、延迟和成本的“最佳 RAG 方案”;不要把方案清单当成答案。

费曼学徒冬瓜 · Bilibili
官方接口记录时长为 1 小时 10 分 03 秒;简介将知识库描述为典型的大模型应用,并以 RAG 为主题展开。
我的评价适合作为 RAG 的起点,先建立文档、分块、检索与回答之间的完整因果关系。
建议同步实现一条最小链路,并维护一张包含问题、命中文档、回答和错误原因的评测表。
边界标题中的“全集”不等于生产级覆盖;框架选择与检索效果仍需用真实资料集验证。
已核验网站
把适合长期阅读、即时查阅、源码协作和项目实作的网站放在一起,避免收藏之后再也找不到。


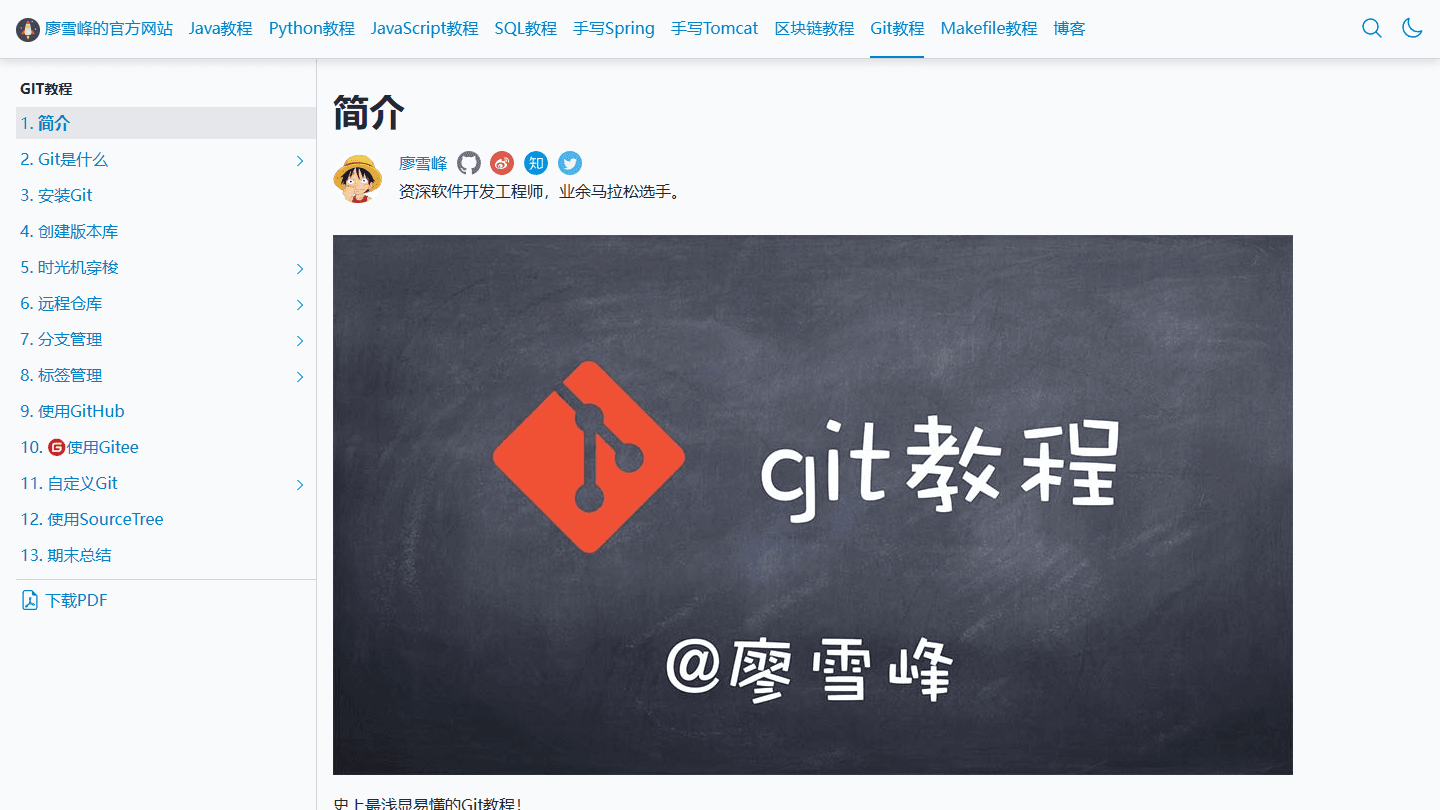
廖雪峰 · Git 文字教程
教程从安装、版本库、工作区和暂存区开始,继续覆盖远程仓库、分支、冲突、多人协作、Rebase、标签与 GitHub。
我的评价它的章节顺序很适合把 Git 的概念串起来,特别是当只会输入命令、却分不清工作区和暂存区时。
建议按章节在本地练习仓库复现;遇到冲突、撤销和 Rebase 时暂停阅读,亲手制造一次再解决。
边界教程明确面向 Git 使用者而非专家;复杂历史重写和团队规范仍要结合项目约定学习。

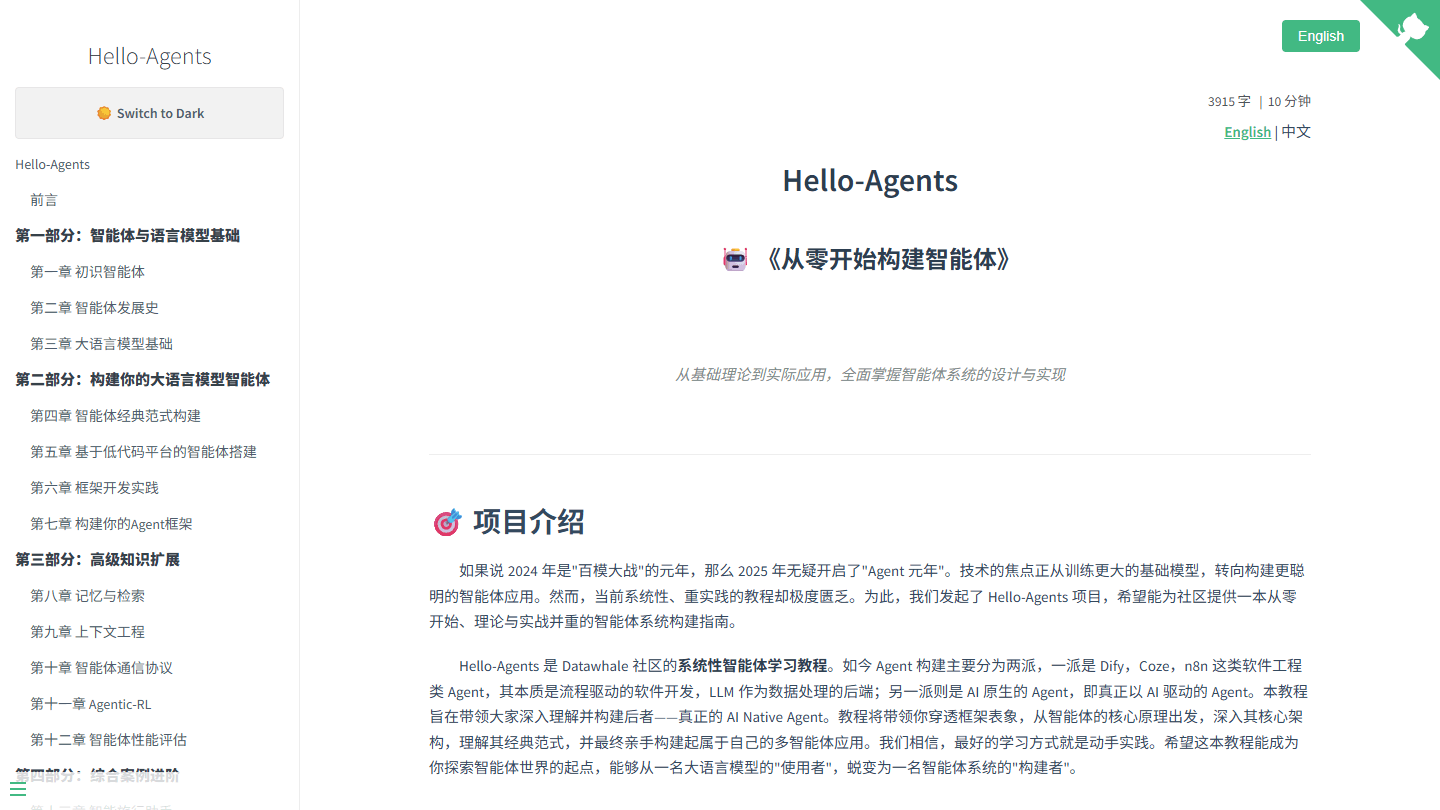
Datawhale · 开源智能体系统教程
Datawhale 的系统性智能体教程,从 LLM 与经典 Agent 范式出发,延伸至记忆、RAG、上下文工程、MCP、评测、Agentic RL 和综合项目。
我的评价这是一条从概念到做项目的完整智能体学习主线,内容广但仍把实践放在中心,和 AI 应用工程方向高度贴合。
建议先完成基础与经典范式,再按顺序做最小 Agent、检索/记忆、上下文工程和一个综合案例。
边界内容跨度很大,需要 Python 和基本 LLM 概念;不要跳过前面基础后直接拼多智能体。

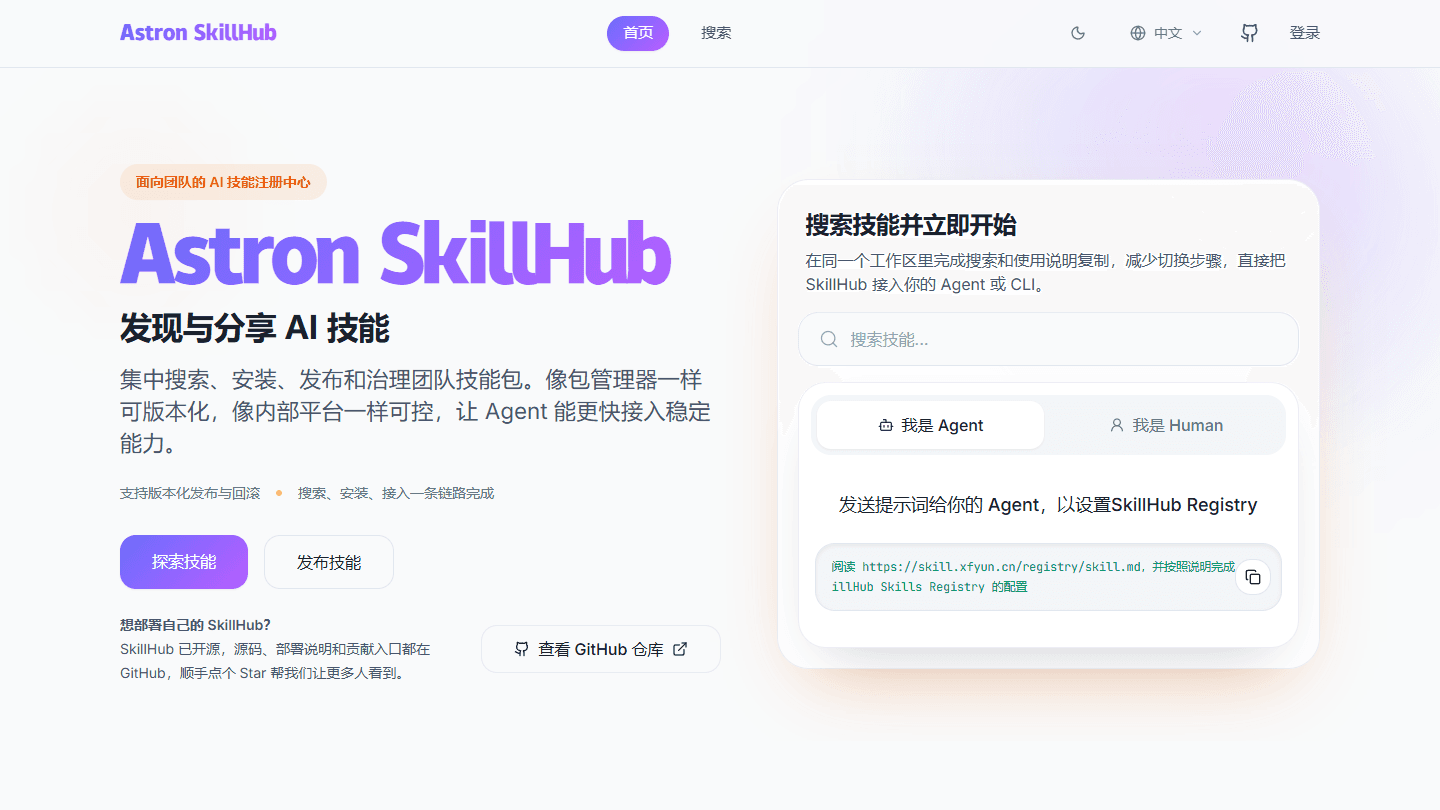
科大讯飞 · AI Agent Skill Registry
站点公开标题为“AI Agent Skill Registry”,可作为观察、检索和比较 Agent Skill 生态与技能封装方式的入口。
我的评价适合在理解 Skill、工具和提示词边界之后查看真实技能包的组织方式,帮助把抽象概念落到可安装、可复用的单元。
建议挑一个与当前项目有关的 Skill,先读清它的输入、输出、依赖和失败边界,再决定是否引入。
边界任何第三方 Skill 在安装或执行前都应查看权限、脚本、网络行为与维护状态。

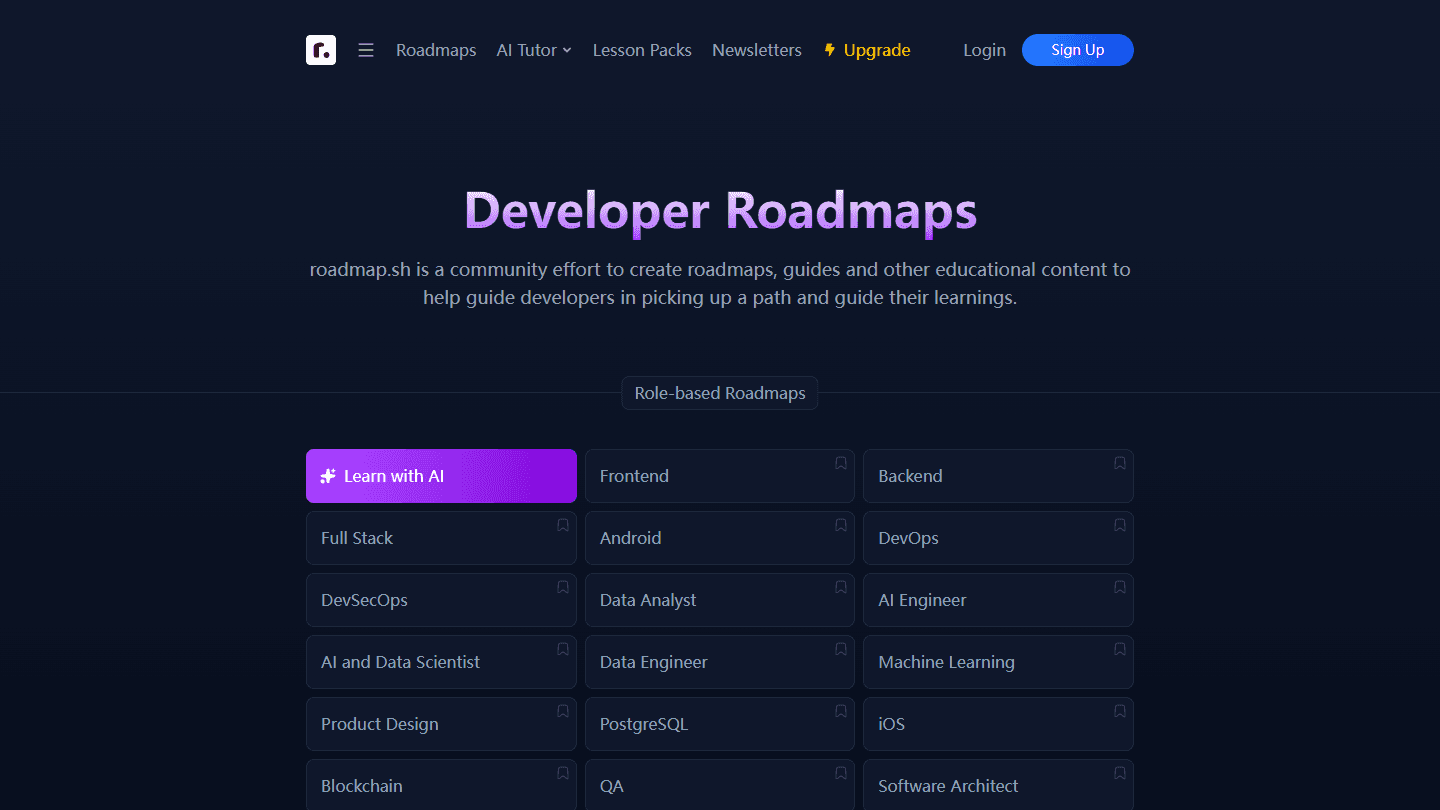
roadmap.sh · 社区开发者路线图
社区维护的路线图、指南和学习内容平台,覆盖 AI Engineer、全栈、后端、机器学习、PostgreSQL、Docker、Redis、Git 等角色与技能路线。
我的评价它最适合回答“下一步学什么”,避免被零散教程牵着走;本项目的技术路线也可以用它做阶段检查。
建议选一条主线,例如 AI Engineer 或 Full Stack,把已掌握、正在学和暂缓的内容标记出来,每月只补一个缺口。
边界路线图是导航而不是待办清单;不要为了点亮节点而在没有项目需求时堆技术名词。

Hugging Face · 官方学习中心
官方学习中心提供 LLM、上下文工程、AI Agent、后训练、深度强化学习、视觉、音频、扩散模型等课程;Agent Course 还包含框架、RAG 用例、评测和最终项目。
我的评价对于希望从调用 API 继续理解模型、工具和智能体构建的人,这是资料质量与动手路径都很好的官方入口。
建议先选一门主课,例如 Agent Course;按单元完成测验或作业,把作品发布到 Hub 或项目仓库中。
边界课程多且更新快,先按当前项目目标选一条,不要同时打开所有方向导致没有产出。
内容数据src/data/learning-resources.ts · 来源与插图核验于 2026-09-08
9 篇真实 Markdown 学习笔记已进入静态内容系统;首页负责索引,每篇都有完整阅读页,原始桌面文件保持不动。
个人学习笔记
09 篇 Markdown
从 Agent 基础架构、ReAct、Planning、Memory 与 Context Engineering,一直整理到 MCP、Tool Engineering 和 Skill Engineering 的长期学习笔记。
从浏览器、React、Next.js、FastAPI 与数据库,一直串到 LLM、RAG、Agent、微调和系统设计的完整速查地图。
105 道高频问题,按“结论、原理、取舍、项目落点”组织,用来训练能解释工程决策的回答,而不是背诵术语。
围绕 Model、Instructions、Tools、Context 和 Runtime 建立 Agent 基础框架,并继续整理路由、记忆与上下文工程。
从生产确认、队列持久化、消费者 ACK 到 RabbitMQ 与 Kafka 的场景差异,整理消息可靠性完整链路。
从 Server、Database、Schema、Table 的层级开始,整理 CRUD、约束、查询与 PostgreSQL 基础操作。
一份短小的本地运行手册:确认 Docker、查找镜像和容器、启动 Redis,并进入 redis-cli 验证状态。
记录模型配置、工作区审查、分支对比、提交审查、预览模式和 delegate 模式等常用命令与注意事项。
内容来源content/notes/*.md · src/data/notes.ts
13 个项目都来自实际使用、阅读或持续关注;推荐理由、适用场景、个人判断与明确缺点同时展示,收藏和分支数据均标出核验日期。
开源推荐
13 个已核验项目

“一切皆插件”不是一句口号:Cordis 驱动的插件架构、会话缓存命中率可视化,以及为压缩请求复用前缀 KV Cache 的设计,让长会话的成本与行为都更可解释。

确定性审查流水线与可调用工具的 LLM Agent 组合,比一段普通 review Skill 更能稳定覆盖改动文件,并给出精确到行的缺陷与安全问题。

开源、成熟度高,并保留了接近 Claude Code 的终端 Agent 工作节奏;内置 build、只读 plan 与通用子 Agent,适合真实代码库任务。

一组小而可组合的软件工程 Skill,从需求拷问、领域建模与决策记录,到 TDD、疑难排障和代码审查,覆盖真实开发的完整反馈回路。

把截图、Figma、Mockup 甚至屏幕录制直接转换成 HTML、React、Vue 等可运行前端,是从视觉参考进入代码实现的黑科技入口。

用一个终端区域管理多个 AI 编程助手,并把每个 pane 标记为 working、blocked 或 idle;支持 Claude Code、Codex、Cursor、OpenCode 等现有工具。

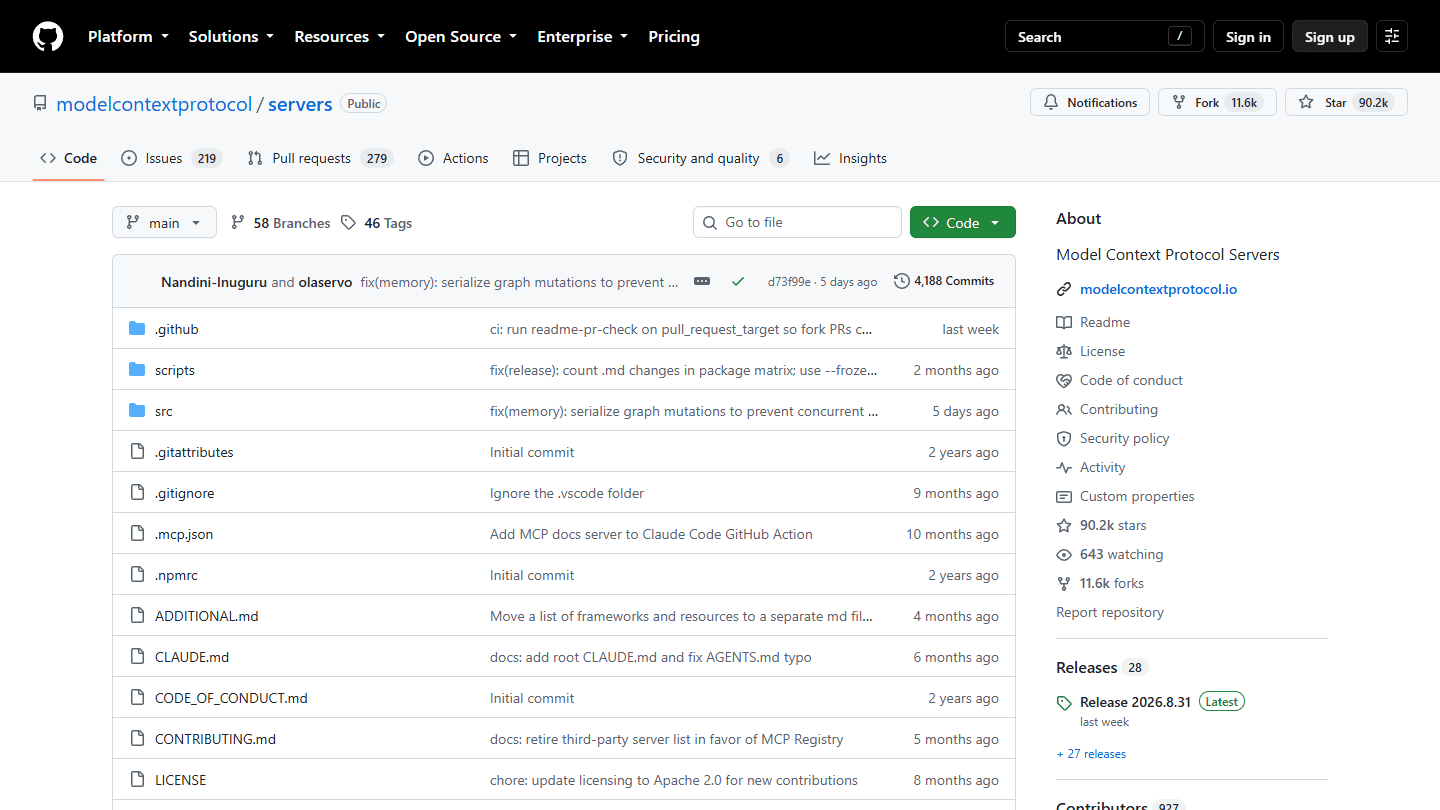
官方仓库收录 Model Context Protocol Servers,是理解 Agent 如何把外部工具和数据能力以统一协议接入的重要入口。
内容数据src/data/recommendations.ts · GitHub API 核验于 2026-09-08
把当前、下一步和长期方向放在同一条路线里,学习目标始终服务于可交付产品。
从需求、架构到前后端交付,持续沉淀可复用的工程方法。
让模型效果、服务稳定性与产品反馈都能够被验证。
在真实需求出现时,继续学习微调与 ComfyUI 等方向。
这是基于目前实践范围和可说明证据的自我评估,不是证书式评分;正在学习的内容会单独标记。
1 为正在建立基础,2 为可跟随文档完成,3 为可在明确范围内独立交付,4 为能处理多步骤与排障,5 为可复用并指导他人。当前不把任何能力写成 5 分。
能在明确需求下设计模型调用、结构化输出与人工复核环节。
当前依据Doc2Alpaca 将候选问答生成、审核与导出分开,避免把模型输出直接当最终数据。
能把复杂任务拆成可观察、可恢复的工具调用与步骤边界。
当前依据ArchPilot 把需求澄清、模块契约和分阶段执行串成可检查的工作流;相关原理也持续沉淀在学习笔记中。
正在系统练习检索、引用、重排与评测,不把概念学习误写成生产能力。
当前依据已整理 RAG 课程与 Agent / Context 笔记;下一步需要用真实语料、问题集和指标做一条完整验证链路。
已理解数据准备的重要性,正在补齐训练、对照实验与评估实践。
当前依据Doc2Alpaca 已能把文档整理为可审核的 Alpaca / ShareGPT 数据;尚未把训练系统包装成已交付能力。
用于 AI 应用逻辑、数据处理与验证脚本,能在明确范围内独立完成后端任务。
当前依据ArchPilot 公开仓库包含 Python 校验脚本;个人知识系统也围绕 Python 后端与 AI 工具持续整理。
能组织输入校验、错误契约、异步写入与面向页面的服务接口。
当前依据当前作品集包含可运行的 FastAPI 联系接口、测试与部署链路;下一步继续补强更复杂的业务与鉴权场景。
能为业务记录、任务历史与元数据设计基础表结构、查询和事务边界。
当前依据Doc2Alpaca 的架构把历史记录放在 PostgreSQL;个人网站后端也以关系数据与迁移作为可验证的工程基础。
理解缓存、会话、限流和短期任务状态的常见场景,正在继续补齐失效与故障处理。
当前依据Doc2Alpaca 用 Redis 保存短期任务进度;已有 Redis 原理和 Docker 启动流程笔记。
能做响应式页面、静态内容路由、元数据和面向真实内容的数据驱动组件。
当前依据当前作品集与 Doc2Alpaca 都有可运行的 Next.js 产品界面;本项目完整覆盖主页、详情、笔记和 404。
能以设计 token 和响应式约束组织界面,持续加强复杂组件与设计系统的复用能力。
当前依据当前网站的视觉系统由 token、断点、无障碍状态和多套配色驱动;项目中也保留 Tailwind 的工程基础。
能用统一配置编排多服务本地环境,并理解 Web、Worker 与基础服务的职责边界。
当前依据Doc2Alpaca 通过 Compose 编排 Web、Worker、PostgreSQL、Redis 与 RabbitMQ 五类服务。
已能维护当前项目从 main 推送到服务器更新的实际流水线,仍在系统补齐通用发布策略。
当前依据此作品集已使用私有 GitHub 仓库、GitHub Actions 与 Windows 服务完成自动更新部署。